library(ggplot2)
library(dplyr)
library(tidyr)
library(readxl)
library(FactoMineR)
library(factoextra)
library(agricolae)6 Analisis Data QDA: ANOVA, Uji Lanjut, dan PCA
Membandingkan profil tekstur dan flavour antar produk
6.1 Tujuan Pembelajaran
Setelah sesi ini, mahasiswa akan mampu:
| Mengetahui | Memahami | Melakukan |
|---|---|---|
| Struktur data QDA: panelis × produk × replikasi × atribut | ANOVA menjawab “apakah produk berbeda?”, uji lanjut menjawab “produk mana yang berbeda?” | Menjalankan ANOVA dengan aov() untuk satu atribut |
| Arti nilai p dan perbedaan nyata \(\alpha\) = 0,05 | Mengapa panelis dimasukkan ke dalam model ANOVA | Melakukan uji lanjut Tukey dengan TukeyHSD() dan HSD.test() |
| Konsep dasar PCA: mengubah banyak atribut menjadi beberapa dimensi | Tidak semua atribut mampu membedakan produk | Membuat peta produk dengan PCA() dan fviz_pca_biplot() |
| Istilah loading, dimensi, dan % variansi | Menafsirkan sumbu PCA menggunakan atribut yang menyusunnya |
6.2 Sekilas tentang QDA
Quantitative Descriptive Analysis (QDA) adalah metode di mana sekelompok panelis terlatih menilai intensitas atribut sensoris suatu produk. Panelis terlatih berperan seperti instrumen ukur: mereka dilatih hingga memberikan angka yang konsisten untuk atribut yang sama.
Data yang akan kita gunakan berasal dari uji QDA terhadap 5 merek nugget ayam (A, B, C, D, E) oleh 12 panelis terlatih dengan 3 kali replikasi. Setiap panelis menilai 8 atribut pada skala garis 0–15.
| Kelompok | Atribut | Definisi singkat |
|---|---|---|
| Tekstur | T_kerenyahan |
Bunyi dan rasa renyah lapisan luar pada gigitan pertama |
| Tekstur | T_kekerasan |
Gaya yang dibutuhkan untuk menggigit sampai putus |
| Tekstur | T_juiciness |
Banyaknya cairan yang keluar saat dikunyah |
| Tekstur | T_kekenyalan |
Kemampuan sampel kembali ke bentuk semula setelah ditekan |
| Rasa | R_umami |
Intensitas rasa umami |
| Rasa | R_asin |
Intensitas rasa asin |
| Flavour | O_ayam |
Intensitas aroma daging ayam |
| Flavour | O_rempah |
Intensitas aroma bumbu (bawang, merica) |
Total baris data: 12 panelis × 5 produk × 3 replikasi = 180 baris.
Data tersimpan pada file qda_nugget.xlsx, lembar Data. Lembar Keterangan pada file yang sama memuat definisi setiap kolom. Jika Anda ingin menginput data hasil praktikum kelompok Anda sendiri, gunakan template_input_qda.xlsx yang formatnya sudah sesuai. Cukup hapus baris contoh berwarna kuning, isi datanya, lalu ganti nama file pada perintah read_excel() di bawah.
6.3 Memuat Data
qda <- as.data.frame(read_excel("assets/data/qda_nugget.xlsx", sheet = "Data"))

# Kolom kategorikal harus berupa factor
qda$panelis   <- as.factor(qda$panelis)
qda$produk    <- as.factor(qda$produk)
qda$replikasi <- as.factor(qda$replikasi)

str(qda)
'data.frame': 180 obs. of 11 variables:
$ panelis : Factor w/ 12 levels "P01","P02","P03",..: 1 1 1 1 1 1 1 1 1 1 ...
$ produk : Factor w/ 5 levels "A","B","C","D",..: 1 1 1 2 2 2 3 3 3 4 ...
$ replikasi : Factor w/ 3 levels "1","2","3": 1 2 3 1 2 3 1 2 3 1 ...
$ T_kerenyahan: num 10.9 12.8 11.2 8.3 12.6 10.5 9.8 8.9 6.7 5.1 ...
$ T_kekerasan : num 7.1 7.3 8.4 9.4 7.8 8.4 10.9 9.4 10.4 12.6 ...
$ T_juiciness : num 8.9 9.1 7.9 9.5 7.8 7.7 4 2.6 2.3 2.1 ...
$ T_kekenyalan: num 7.5 6.9 7.8 8.5 9.4 9.4 11.8 11.5 9 10.6 ...
$ R_umami : num 12.7 11.6 10.9 12 9.8 11.3 8.6 7.4 6.5 6.3 ...
$ R_asin : num 8.5 6.2 6.9 8.5 10 7.5 8.2 8 7.6 9.1 ...
$ O_ayam : num 8.7 11.2 10.8 9.8 12.1 10.1 7.5 4.9 4.7 4 ...
$ O_rempah : num 8.3 5.7 8.9 9.7 8.1 9.7 9.1 7.7 8.1 8 ...head(qda)Think-aloud: “Sebelum menganalisis apa pun, saya memeriksa apakah rancangannya lengkap. Saya jalankan
table(qda$panelis, qda$produk), kalau semua selnya berisi 3, artinya setiap panelis menilai setiap produk sebanyak tiga kali. Rancangan yang lengkap dan seimbang membuat ANOVA jauh lebih mudah ditafsirkan.”
table(qda$panelis, qda$produk)
      A B C D E
  P01 3 3 3 3 3
  P02 3 3 3 3 3
  P03 3 3 3 3 3
  P04 3 3 3 3 3
  P05 3 3 3 3 3
  P06 3 3 3 3 3
  P07 3 3 3 3 3
  P08 3 3 3 3 3
  P09 3 3 3 3 3
  P10 3 3 3 3 3
  P11 3 3 3 3 3
  P12 3 3 3 3 3
6.4 Eksplorasi Awal
# Rata-rata setiap atribut untuk setiap produk
tabel_rata <- aggregate(cbind(T_kerenyahan, T_kekerasan, T_juiciness, T_kekenyalan,
                              R_umami, R_asin, O_ayam, O_rempah) ~ produk,
                        data = qda, FUN = mean)

tabel_rata_bulat <- tabel_rata
tabel_rata_bulat[, -1] <- round(tabel_rata_bulat[, -1], 2) # Membulatkan menjadi 2 angka di belakang koma pada semua kolom kecuali kolom pertama
tabel_rata_bulat
Untuk membuat grafik semua atribut sekaligus, data perlu diubah ke format panjang, yaitu satu baris untuk satu kombinasi produk × atribut × panelis:
qda_panjang <- pivot_longer(qda,
                            cols = T_kerenyahan:O_rempah,
                            names_to = "atribut",
                            values_to = "intensitas")

head(qda_panjang)
Visualisasikan datanya, sehingga lebih mudah untuk diamati.
ggplot(qda_panjang, aes(x = produk, y = intensitas, fill = produk)) +
  geom_boxplot() +
  facet_wrap(~ atribut, ncol = 4) +
  labs(title = "Profil Sensoris 5 Merek Nugget Ayam",
       x = "Produk", y = "Intensitas (skala 0-15)") +
  theme_minimal() +
  theme(legend.position = "none")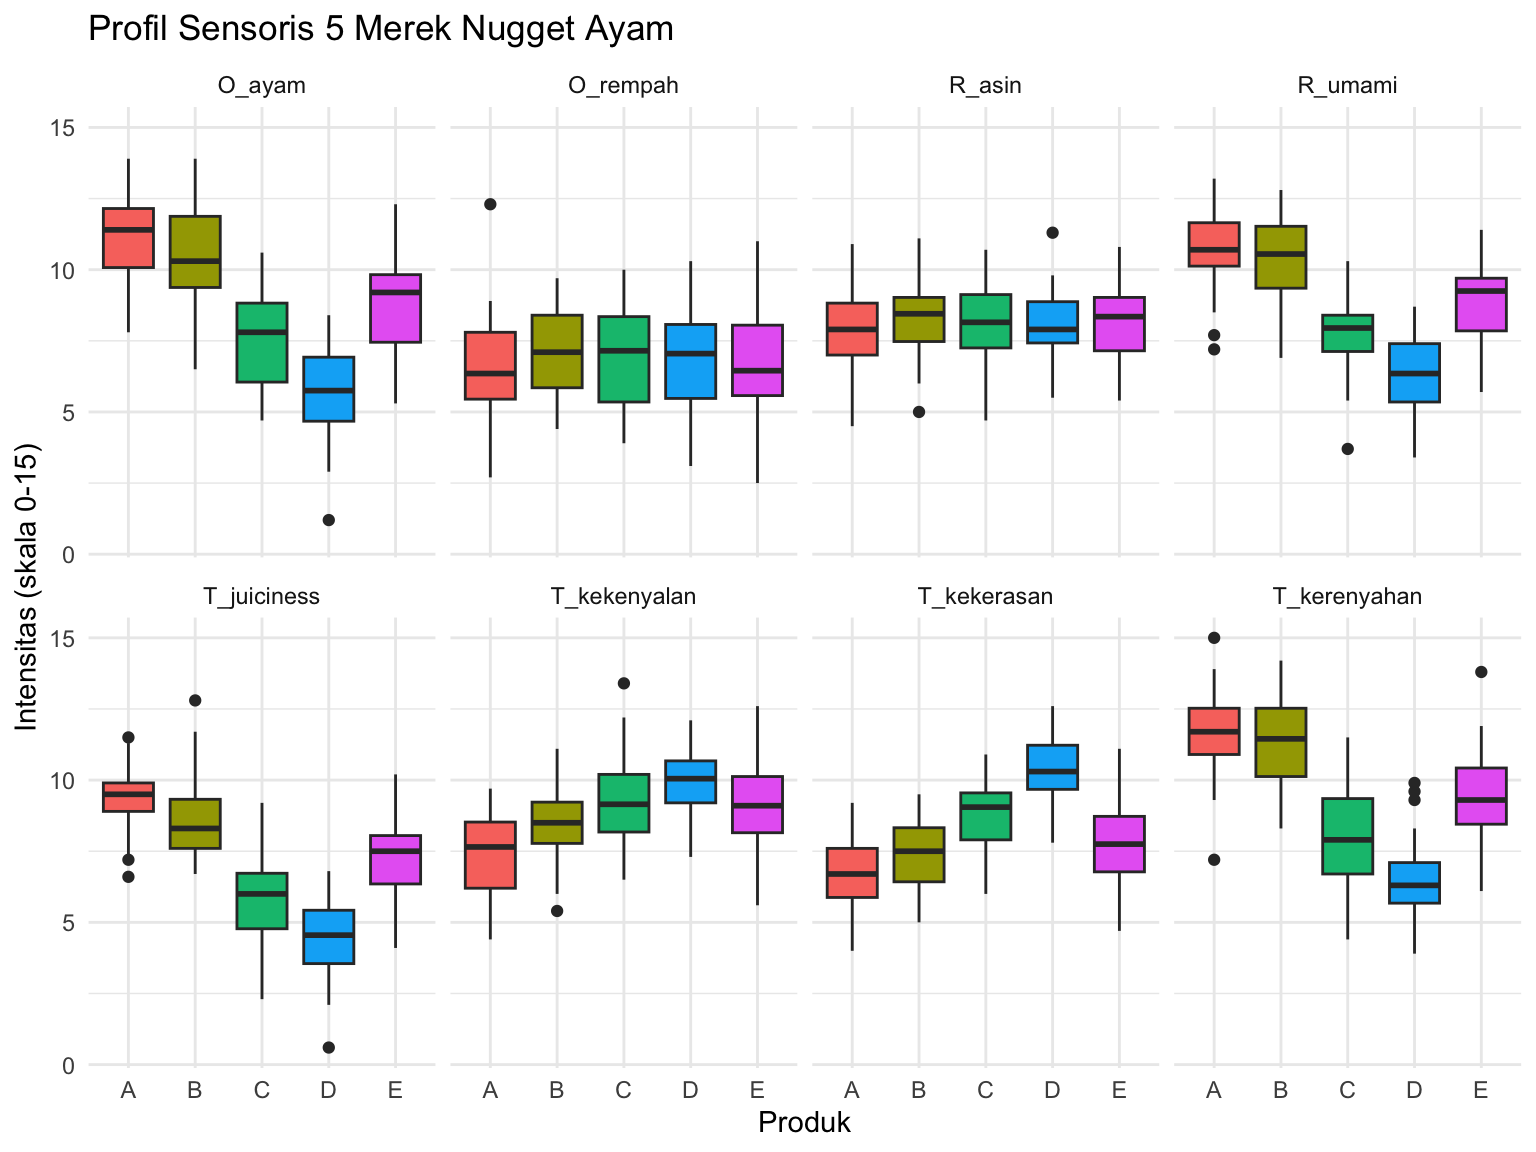
Amati grafik ini sebelum menghitung apa pun. Pada atribut mana kotak-kotaknya jelas terpisah antar produk? Pada atribut mana kotak-kotaknya bertumpuk? Dugaan Anda dari grafik akan kita uji dengan ANOVA di bagian berikutnya.
6.5 ANOVA untuk Satu Atribut
Pertanyaannya: apakah kelima produk berbeda nyata dalam atribut kerenyahan?
- \(H_0\) (hipotesis nol): rata-rata kerenyahan kelima produk sama
- \(H_1\) (hipotesis alternatif): paling tidak ada satu produk yang berbeda
model_renyah <- aov(T_kerenyahan ~ produk + panelis, data = qda)
summary(model_renyah)
Df Sum Sq Mean Sq F value Pr(>F)
produk 4 695.7 173.93 136.67 <2e-16 ***
panelis 11 190.2 17.29 13.59 <2e-16 ***
Residuals 164 208.7 1.27
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Cara membacanya:
| Kolom | Arti |
|---|---|
Df |
Derajat bebas. Untuk 5 produk \(\rightarrow\) 5 - 1 = 4 |
F value |
Rasio keragaman (Mean Sq) antar produk terhadap keragaman residual/error. Makin besar, makin kuat bukti adanya perbedaan |
Pr(>F) |
Nilai p. Inilah yang kita baca. Jika < 0,05 \(\rightarrow\) tolak \(H_0\) |
*** |
Penanda tingkat signifikansi (*** = p < 0,001) |
Mengapa
panelisikut dimasukkan ke dalam model? Setiap panelis punya kebiasaan menggunakan skala secara berbeda, ada yang menggunakan skala bagian atas, maupun bagian bawah. Walaupun perbedaan itu bukan efek produk, perbedaan itu tetap menambah variasi data. Dengan menuliskan+ panelis, variasi antar panelis “dikeluarkan” dari sisa (residual), sehingga uji terhadap efek produk menjadi lebih peka. Konsep ini sama dengan rancangan acak kelompok (RAK), dengan panelis sebagai kelompok.
6.5.1 Hinge Question
Sebelum melanjutkan, jawablah: Hasil ANOVA menunjukkan nilai p untuk
produksebesar 2e-16. Apa kesimpulan yang benar?
- Kelima produk berbeda nyata satu sama lain
- Paling tidak ada satu produk yang berbeda nyata dari yang lain, tetapi kita belum tahu yang mana
- Produk A adalah yang paling renyah
- Panelis menilai dengan tidak konsisten
Jawaban: B. ANOVA hanya menjawab “apakah ada perbedaan”, bukan “produk mana yang berbeda”. Untuk itu kita memerlukan uji lanjut.
6.6 Uji Lanjut (Post-hoc)
6.6.1 Tukey HSD
Uji Tukey membandingkan semua pasangan produk, sambil mengendalikan probabilitas dalam menyimpulkan secara salah akibat banyaknya perbandingan.
tukey_renyah <- TukeyHSD(model_renyah, which = "produk")
tukey_renyah
Tukey multiple comparisons of means
95% family-wise confidence level
Fit: aov(formula = T_kerenyahan ~ produk + panelis, data = qda)
$produk
diff lwr upr p adj
B-A -0.4027778 -1.1362141 0.3306585 0.5543826
C-A -3.7361111 -4.4695474 -3.0026748 0.0000000
D-A -5.1944444 -5.9278808 -4.4610081 0.0000000
E-A -2.3305556 -3.0639919 -1.5971192 0.0000000
C-B -3.3333333 -4.0667697 -2.5998970 0.0000000
D-B -4.7916667 -5.5251030 -4.0582303 0.0000000
E-B -1.9277778 -2.6612141 -1.1943415 0.0000000
D-C -1.4583333 -2.1917697 -0.7248970 0.0000015
E-C 1.4055556 0.6721192 2.1389919 0.0000039
E-D 2.8638889 2.1304526 3.5973252 0.0000000Setiap baris adalah satu pasangan produk. Kolom p adj adalah nilai p yang sudah dikoreksi: jika < 0,05, kedua produk itu berbeda nyata.
plot(tukey_renyah, las = 1)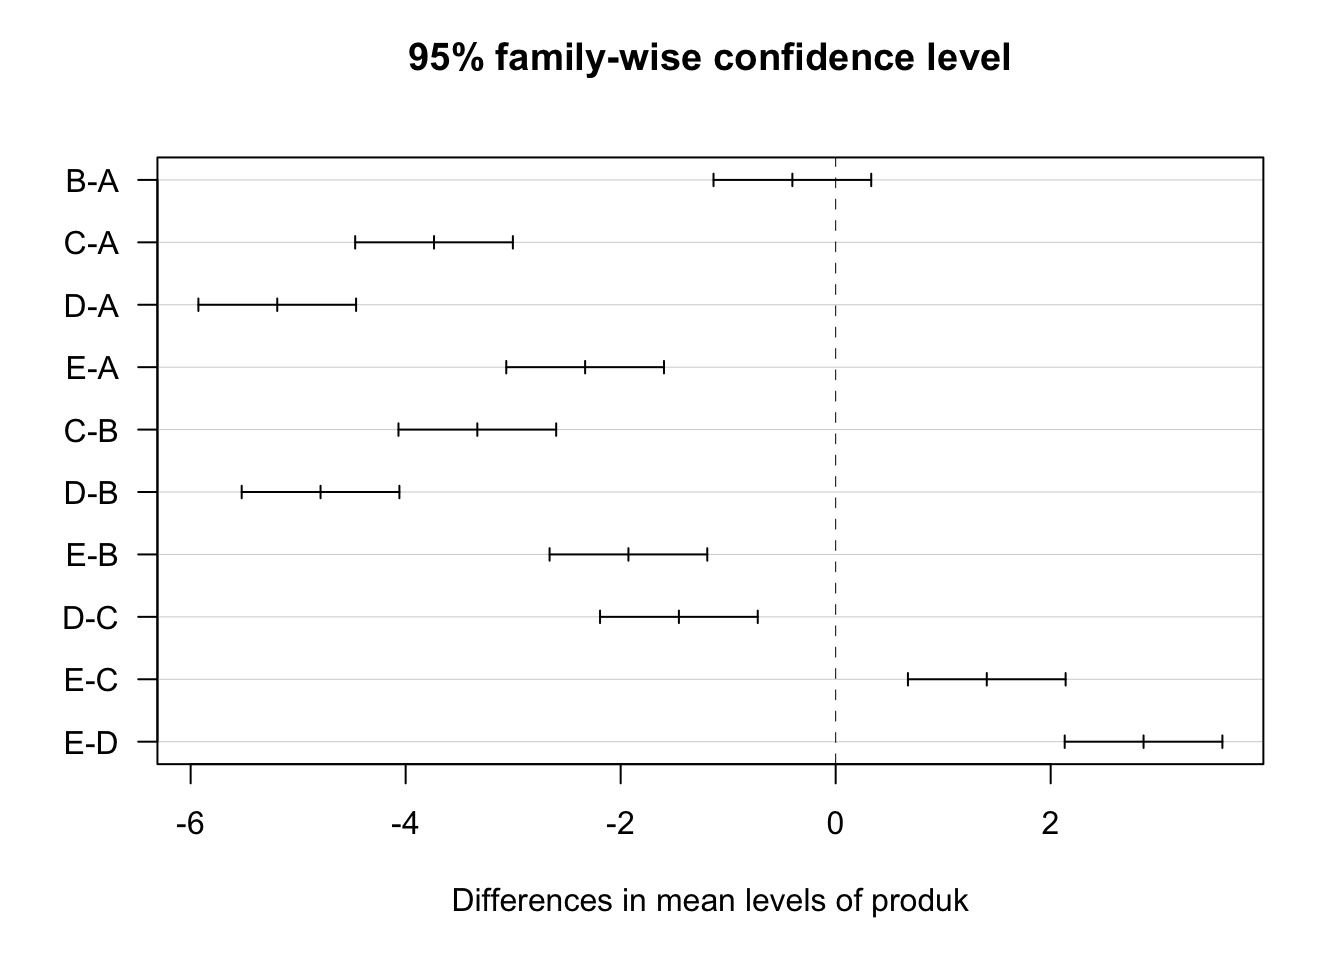
Cara membaca grafik ini: setiap garis adalah confidence interval (CI) untuk selisih rata-rata sepasang produk. Jika garisnya memotong angka nol (garis putus-putus), kedua produk tersebut tidak berbeda nyata.
Pada hasil uji lanjut Tukey, dapat dilihat bahwa hanya produk A-B yang tidak berbeda nyata.
6.6.2 Notasi Huruf
Hasil uji lanjut biasanya disajikan sebagai notasi huruf: produk dengan huruf yang sama berarti tidak berbeda nyata.
hsd_renyah <- HSD.test(model_renyah, "produk", group = TRUE)
hsd_renyah$groups
Think-aloud: “Saya membaca tabel ini dari atas ke bawah. Produk sudah diurutkan dari rata-rata tertinggi. Produk yang berbagi huruf yang sama tidak berbeda nyata. Inilah bentuk yang saya salin ke tabel laporan, dengan huruf ditulis sebagai superskrip di belakang nilai rata-rata ± standar deviasi.”
6.7 ANOVA untuk Semua Atribut Sekaligus
Mengulang kode di atas delapan kali akan melelahkan dan rawan salah salin. Kita bisa membuat R melakukannya secara otomatis:
atribut <- c("T_kerenyahan", "T_kekerasan", "T_juiciness", "T_kekenyalan",
             "R_umami", "R_asin", "O_ayam", "O_rempah")

nilai_p <- sapply(atribut, function(a) {
  rumus <- as.formula(paste(a, "~ produk + panelis"))
  model <- aov(rumus, data = qda)
  summary(model)[[1]][["Pr(>F)"]][1] # baris pertama tabel ANOVA adalah efek 'produk'
})

hasil_anova <- data.frame(
  atribut     = atribut,
  p_value     = signif(nilai_p, 3),
  kesimpulan  = ifelse(nilai_p < 0.05,
                       "Berbeda nyata", "Tidak berbeda nyata")
)

hasil_anova
Inilah hasil terpenting dari QDA. Atribut dengan p-value kecil adalah atribut yang mampu membedakan produk. Atribut inilah yang layak dibahas selanjutnya. Atribut dengan nilai p besar berarti kelima produk terasa sama pada atribut tersebut. Hasil “tidak berbeda nyata” bukan kegagalan proses pengambilan data: informasi tersebut juga tetap valid, misalnya bahwa semua merek memakai tingkat penggunaan garam yang serupa.
6.8 PCA: Memetakan Produk
Kita sekarang punya 8 atribut. Membandingkan 5 produk pada 8 sumbu sekaligus sulit dilakukan di kepala. Principal Component Analysis (PCA) memampatkan 8 atribut itu menjadi dua atau tiga dimensi baru yang dapat divisualisasikan sebagai peta.
Gagasannya sederhana: atribut yang berkolerasi (misalnya produk yang renyah cenderung juga juicy) dianggap membawa informasi yang mirip, sehingga bisa diringkas menjadi satu sumbu.
6.8.1 Menyiapkan Tabel Rata-rata
Pada QDA, PCA dilakukan terhadap tabel rata-rata produk × atribut, bukan terhadap 180 baris data mentah, karena yang ingin kita petakan adalah produknya, bukan panelisnya.
tabel_pca <- tabel_rata[, -1]              # buang kolom 'produk'
rownames(tabel_pca) <- tabel_rata$produk   # jadikan nama baris
round(tabel_pca, 2)
6.8.2 Menjalankan PCA
hasil_pca <- PCA(tabel_pca, scale.unit = TRUE, graph = FALSE)Mengapa
scale.unit = TRUE? Perintah ini menstandarkan setiap atribut sehingga semuanya memiliki bobot yang sama. Tanpa itu, atribut yang kebetulan memiliki rentang nilai lebar akan mendominasi peta hanya karena satuannya, bukan karena informasinya lebih penting.
6.8.3 Berapa Dimensi yang Perlu Dilihat?
Sebelum membuat peta produknya, kita perlu tahu seberapa besar informasi asli yang terwakili di dalamnya. Kalau terlalu sedikit, posisi produk pada peta tidak bisa dipercaya.
round(hasil_pca$eig, 2) eigenvalue percentage of variance cumulative percentage of variance
comp 1 5.95 74.34 74.34
comp 2 1.68 21.00 95.34
comp 3 0.32 3.94 99.28
comp 4 0.06 0.72 100.00Kolom ketiga tabel eig (cumulative percentage of variance) adalah persentase kumulatif. Jika dua dimensi pertama sudah menjelaskan lebih dari ±70% keragaman, peta dua dimensi sudah cukup mewakili data.
fviz_eig(hasil_pca, addlabels = TRUE,
         barfill = "steelblue", barcolor = "steelblue") +
  labs(title = "Persentase Varians yang Dijelaskan Tiap Dimensi",
       x = "Dimensi", y = "% varians") +
  theme_minimal()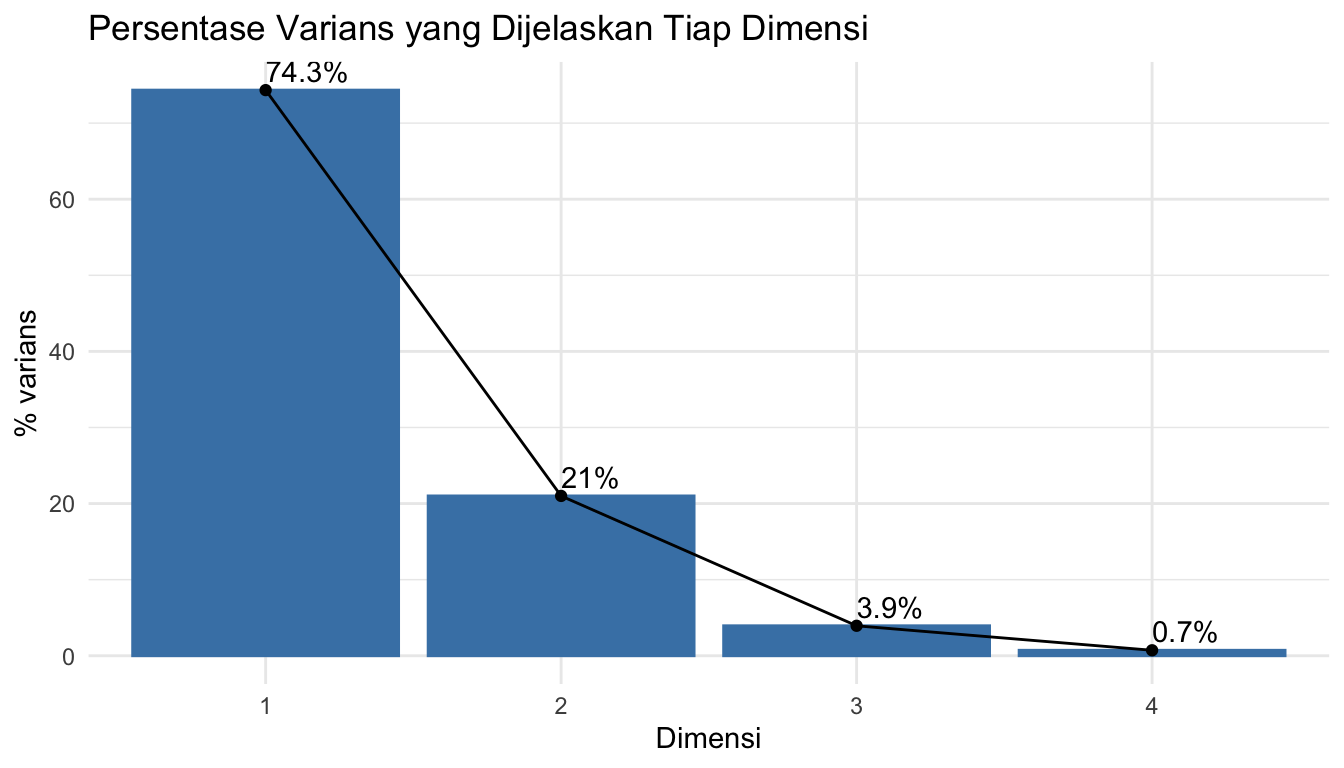
6.8.4 Peta Produk dan Atribut
fviz_pca_biplot(hasil_pca,
                repel = TRUE,
                col.var = "darkred",   # warna panah atribut
                col.ind = "steelblue", # warna titik produk
                title = "PCA Biplot - Peta Sensoris 5 Merek Nugget Ayam")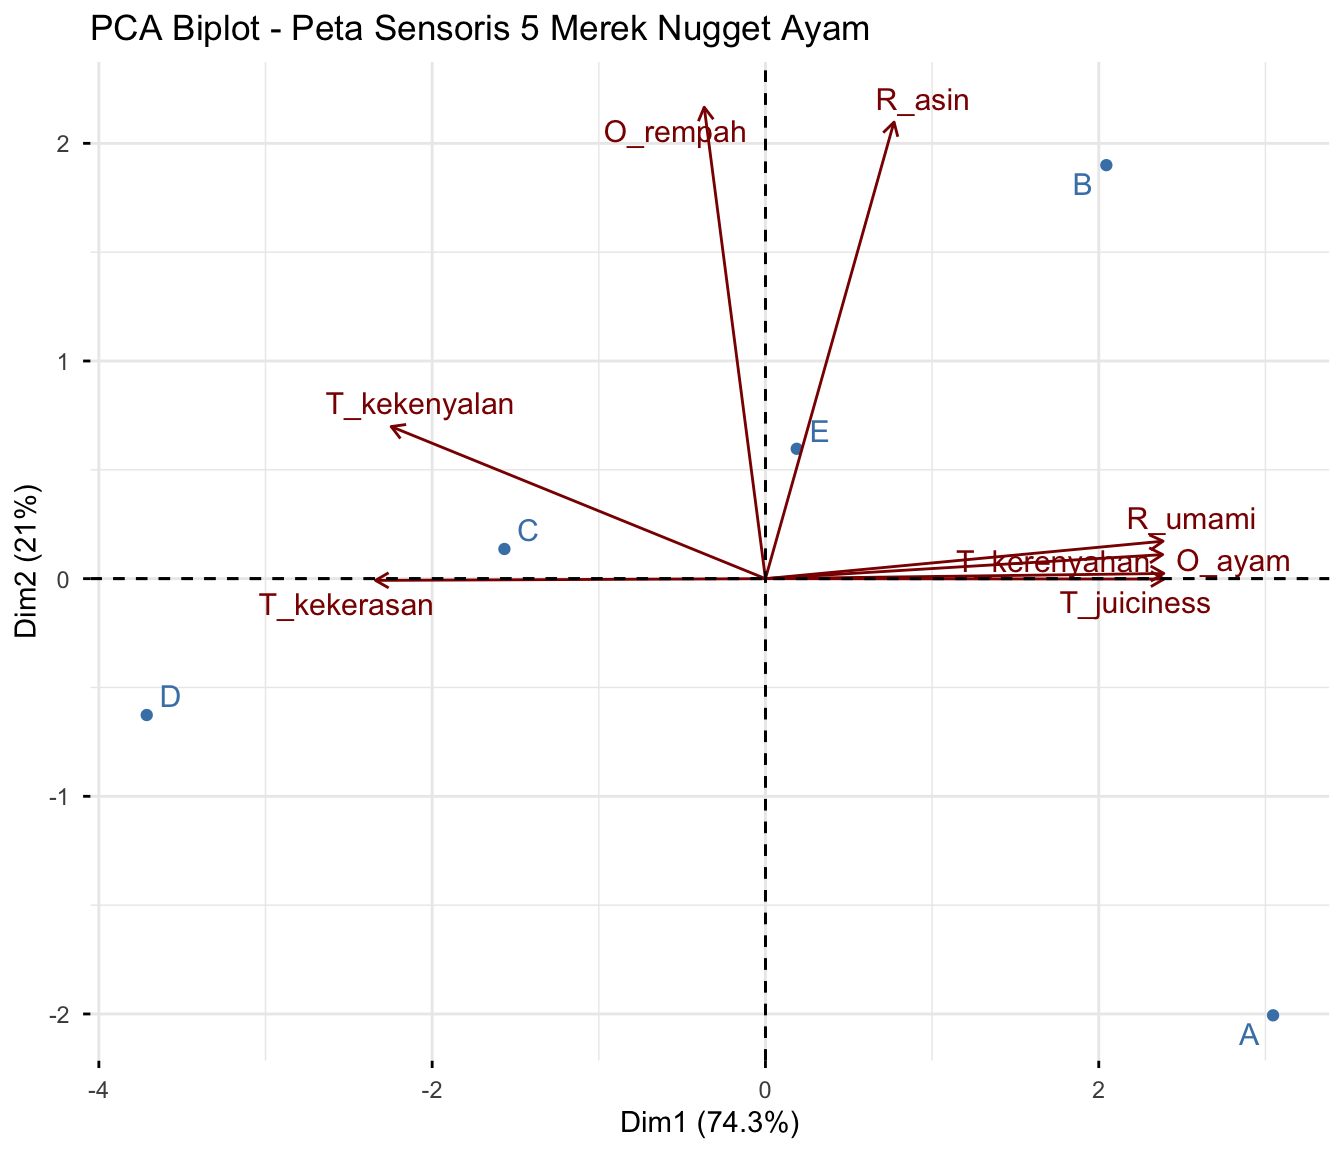
Cara membaca biplot:
| Yang Anda lihat | Artinya |
|---|---|
| Titik biru | Produk. Dua produk yang berdekatan memiliki profil sensoris yang mirip |
| Panah merah | Atribut. Arah panah menunjukkan ke mana produk dengan intensitas tinggi pada atribut itu berada |
| Panah panjang | Atribut tersebut terwakili dengan baik pada peta ini |
| Dua panah searah | Kedua atribut berkorelasi positif |
| Dua panah berlawanan arah | Kedua atribut berkorelasi negatif |
| Panah tegak lurus | Kedua atribut tidak berkorelasi |
| Produk searah dengan panah | Produk itu tinggi pada atribut tersebut |
Think-aloud: “Saya menafsirkan PCA ini dari sumbunya terlebih dahulu, bukan dari titik produknya. Saya lihat atribut apa yang berada di ujung kanan Dimensi 1 (sumbu x) dan apa yang di ujung kiri. Dari situ saya beri nama sumbunya, misalnya ‘renyah dan juicy’ versus ‘keras dan kenyal’. Setelah sumbunya punya nama, posisi produk menjadi mudah dijelaskan dalam satu kalimat.”
Untuk melihat sumbangan tiap atribut terhadap kedua dimensi secara angka:
round(hasil_pca$var$coord[, 1:2], 2) Dim.1 Dim.2
T_kerenyahan 1.00 0.05
T_kekerasan -0.98 0.00
T_juiciness 1.00 0.00
T_kekenyalan -0.94 0.29
R_umami 1.00 0.07
R_asin 0.32 0.88
O_ayam 1.00 0.01
O_rempah -0.15 0.91Nilai ini disebut loading: makin mendekati +1 atau -1, makin kuat atribut tersebut menyusun dimensi yang bersangkutan.
Penting! Peta PCA hanya menganalisis rata-rata produk; PCA tidak menguji apakah ada perbedaannya nyata. Dua produk bisa tampak berjauhan pada peta padahal ANOVA menyatakan mereka tidak berbeda. Karena itu, PCA selalu dibaca bersama tabel hasil ANOVA, bukan menggantikannya. Perhatikan juga bahwa atribut yang tidak nyata pada ANOVA tetap digambar sebagai panah pada peta, padahal sebenarnya tidak membawa informasi apa-apa tentang perbedaan produk.
6.9 Menyusun Kesimpulan
Sebuah kesimpulan QDA yang baik menggabungkan ketiga analisis tadi:
- ANOVA \(\rightarrow\) atribut mana yang mampu membedakan produk?
- Uji lanjut \(\rightarrow\) pada atribut tersebut, produk mana yang berbeda dari mana?
- PCA \(\rightarrow\) bagaimana kelima produk tersusun secara keseluruhan, dan atribut apa yang menjelaskan susunan itu?
Latihan menulis: Susun satu paragraf (4–6 kalimat) yang menjawab ketiga pertanyaan di atas untuk data nugget ini. Sebutkan nilai p dan notasi huruf sebagai pendukung, bukan sebagai isi utama kalimat.
6.10 Latihan (You Do)
6.10.1 Latihan 1: ANOVA dan Uji Lanjut Atribut Lain
- Jalankan ANOVA untuk atribut
aroma_ayam:
model_aroma <- aov(O_ayam ~ produk + panelis, data = qda)
summary(model_aroma)- Lakukan uji lanjut dan tampilkan notasi hurufnya:
HSD.test(model_aroma, "produk", group = TRUE)$groups- Ulangi untuk
asin. Apa yang Anda temukan pada tabel notasi hurufnya, dan mengapa hasilnya seperti itu?
6.10.2 Latihan 2: Tabel Laporan
Buat tabel rata-rata ± simpangan baku gurih untuk setiap produk:
qda %>%
  group_by(produk) %>%
  summarise(rerata = round(mean(R_umami), 2),
            sd     = round(sd(R_umami), 2))
Kemudian tambahkan notasi huruf dari uji lanjut ke dalam tabel tersebut secara manual, seperti format yang lazim dipakai pada laporan praktikum.
6.10.3 Latihan 3: Challenges
- Jalankan ulang PCA hanya menggunakan atribut yang berbeda nyata menurut ANOVA. Apakah posisi produk pada peta berubah? Apakah persentase varians Dimensi 1 naik atau turun? Mengapa?
atribut_nyata <- hasil_anova$atribut[hasil_anova$p_value < 0.05]
pca2 <- PCA(tabel_pca[, atribut_nyata], scale.unit = TRUE, graph = FALSE)
fviz_pca_biplot(pca2, repel = TRUE)- Tambahkan efek interaksi
produk:paneliske dalam model ANOVA untukkerenyahan. Interaksi yang nyata menandakan panelis tidak sepakat dalam mengurutkan produk. Apakah panel ini sepakat?
model_interaksi <- aov(T_kerenyahan ~ produk + panelis + produk:panelis,
                       data = qda)
summary(model_interaksi)- Buat grafik profil garis (bukan boxplot) yang menampilkan rata-rata kelima produk pada kedelapan atribut sekaligus.
qda_panjang %>%
  group_by(produk, atribut) %>%
  summarise(rerata = mean(intensitas), .groups = "drop") %>%
  ggplot(aes(x = atribut, y = rerata, group = produk, color = produk)) +
  geom_line(linewidth = 1) +
  geom_point(size = 2) +
  labs(x = NULL, y = "Intensitas rata-rata (0-15)") +
  theme_minimal() +
  theme(axis.text.x = element_text(angle = 45, hjust = 1))
6.11 Ringkasan
Dalam sesi ini kita telah mempelajari:
- Struktur data QDA: panelis × produk × replikasi × atribut dalam format panjang
- ANOVA dengan aov(atribut ~ produk + panelis) dan alasan memasukkan panelis ke dalam model
- Membaca nilai p untuk menentukan atribut mana yang mampu membedakan produk
- Uji lanjut Tukey dengan TukeyHSD() dan notasi huruf dengan HSD.test()
- Menjalankan ANOVA untuk semua atribut sekaligus menggunakan sapply()
- PCA pada tabel rata-rata produk × atribut dengan PCA() dan menafsirkan biplot
- Bahwa PCA meringkas, sedangkan ANOVA menguji — keduanya saling melengkapi